第一个 Agent:从 20 行到能干活
本合集目录
本章目录
单册说明:本文件是「AI Agent 完整教程」卷 0 的第 5 章,可独立阅读。 前置:必须做完第 3、4 章(实验目录已建、三个环境变量已配、
hello_model.py能跑)。这一章的代码全部在ai-agent-lab/code里。
| 项 | 内容 |
|---|---|
| 所属卷 | 卷 0 · 学习地图(第 5 / 6 章) |
| 前置章节 | 第 3 章(环境)+ 第 4 章(三条链路) |
| 本章产出 | 一个能列目录、读文件、写报告、会收手、写前会问你的 Agent |
| 对应代码 | code/first_agent.py(零依赖,约 200 行) |
| 配图 | 图 0-4(Agent 循环)、图 0-9(上下文膨胀)、图 0-10(四出口 + 人工闸门) |
| 读完的判定 | --mock 能完整跑完并解释每一步;能改任务描述让它做你自己的事 |
5.1 一次问答与一个 Agent 的全部区别
先看区别,再写代码。
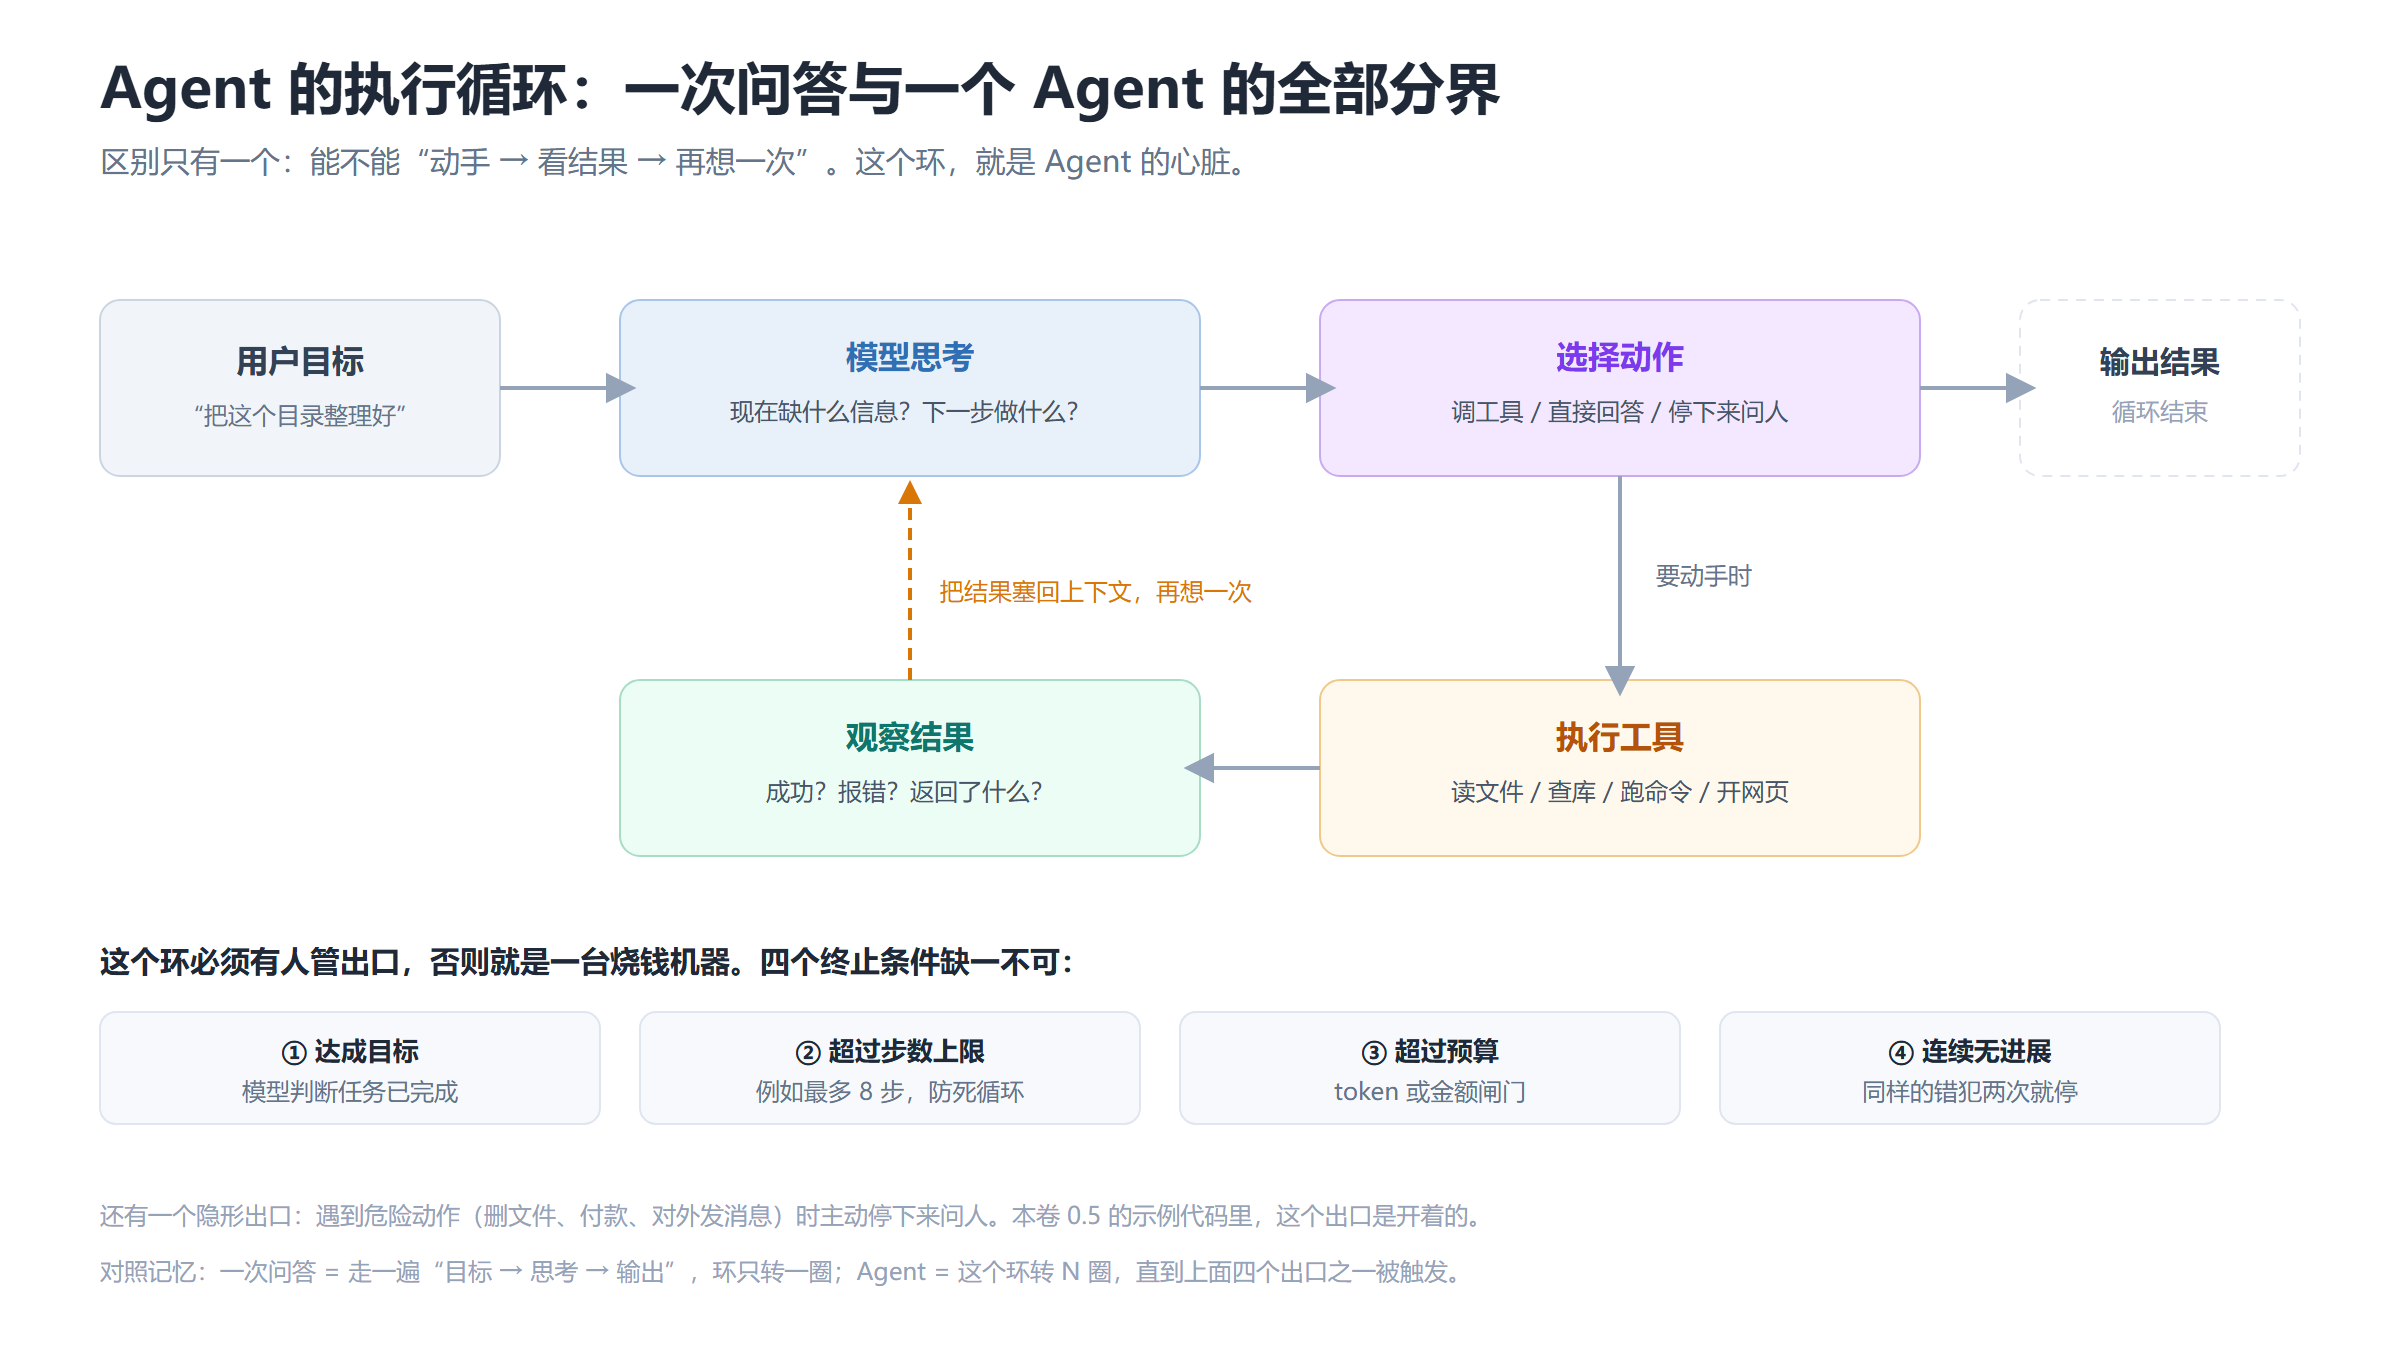
一次问答的流程是:你说 → 它答 → 结束。
Agent 的流程是:你说 → 它想 → 它动手 → 它看结果 → 它再想 → …… → 它说完了。
关键在那个回环:工具的执行结果会被塞回对话里,模型据此决定下一步。这个环,就是 Agent 的心脏。
而这个环必须有出口,否则它就是个烧钱机器。四个出口缺一不可:
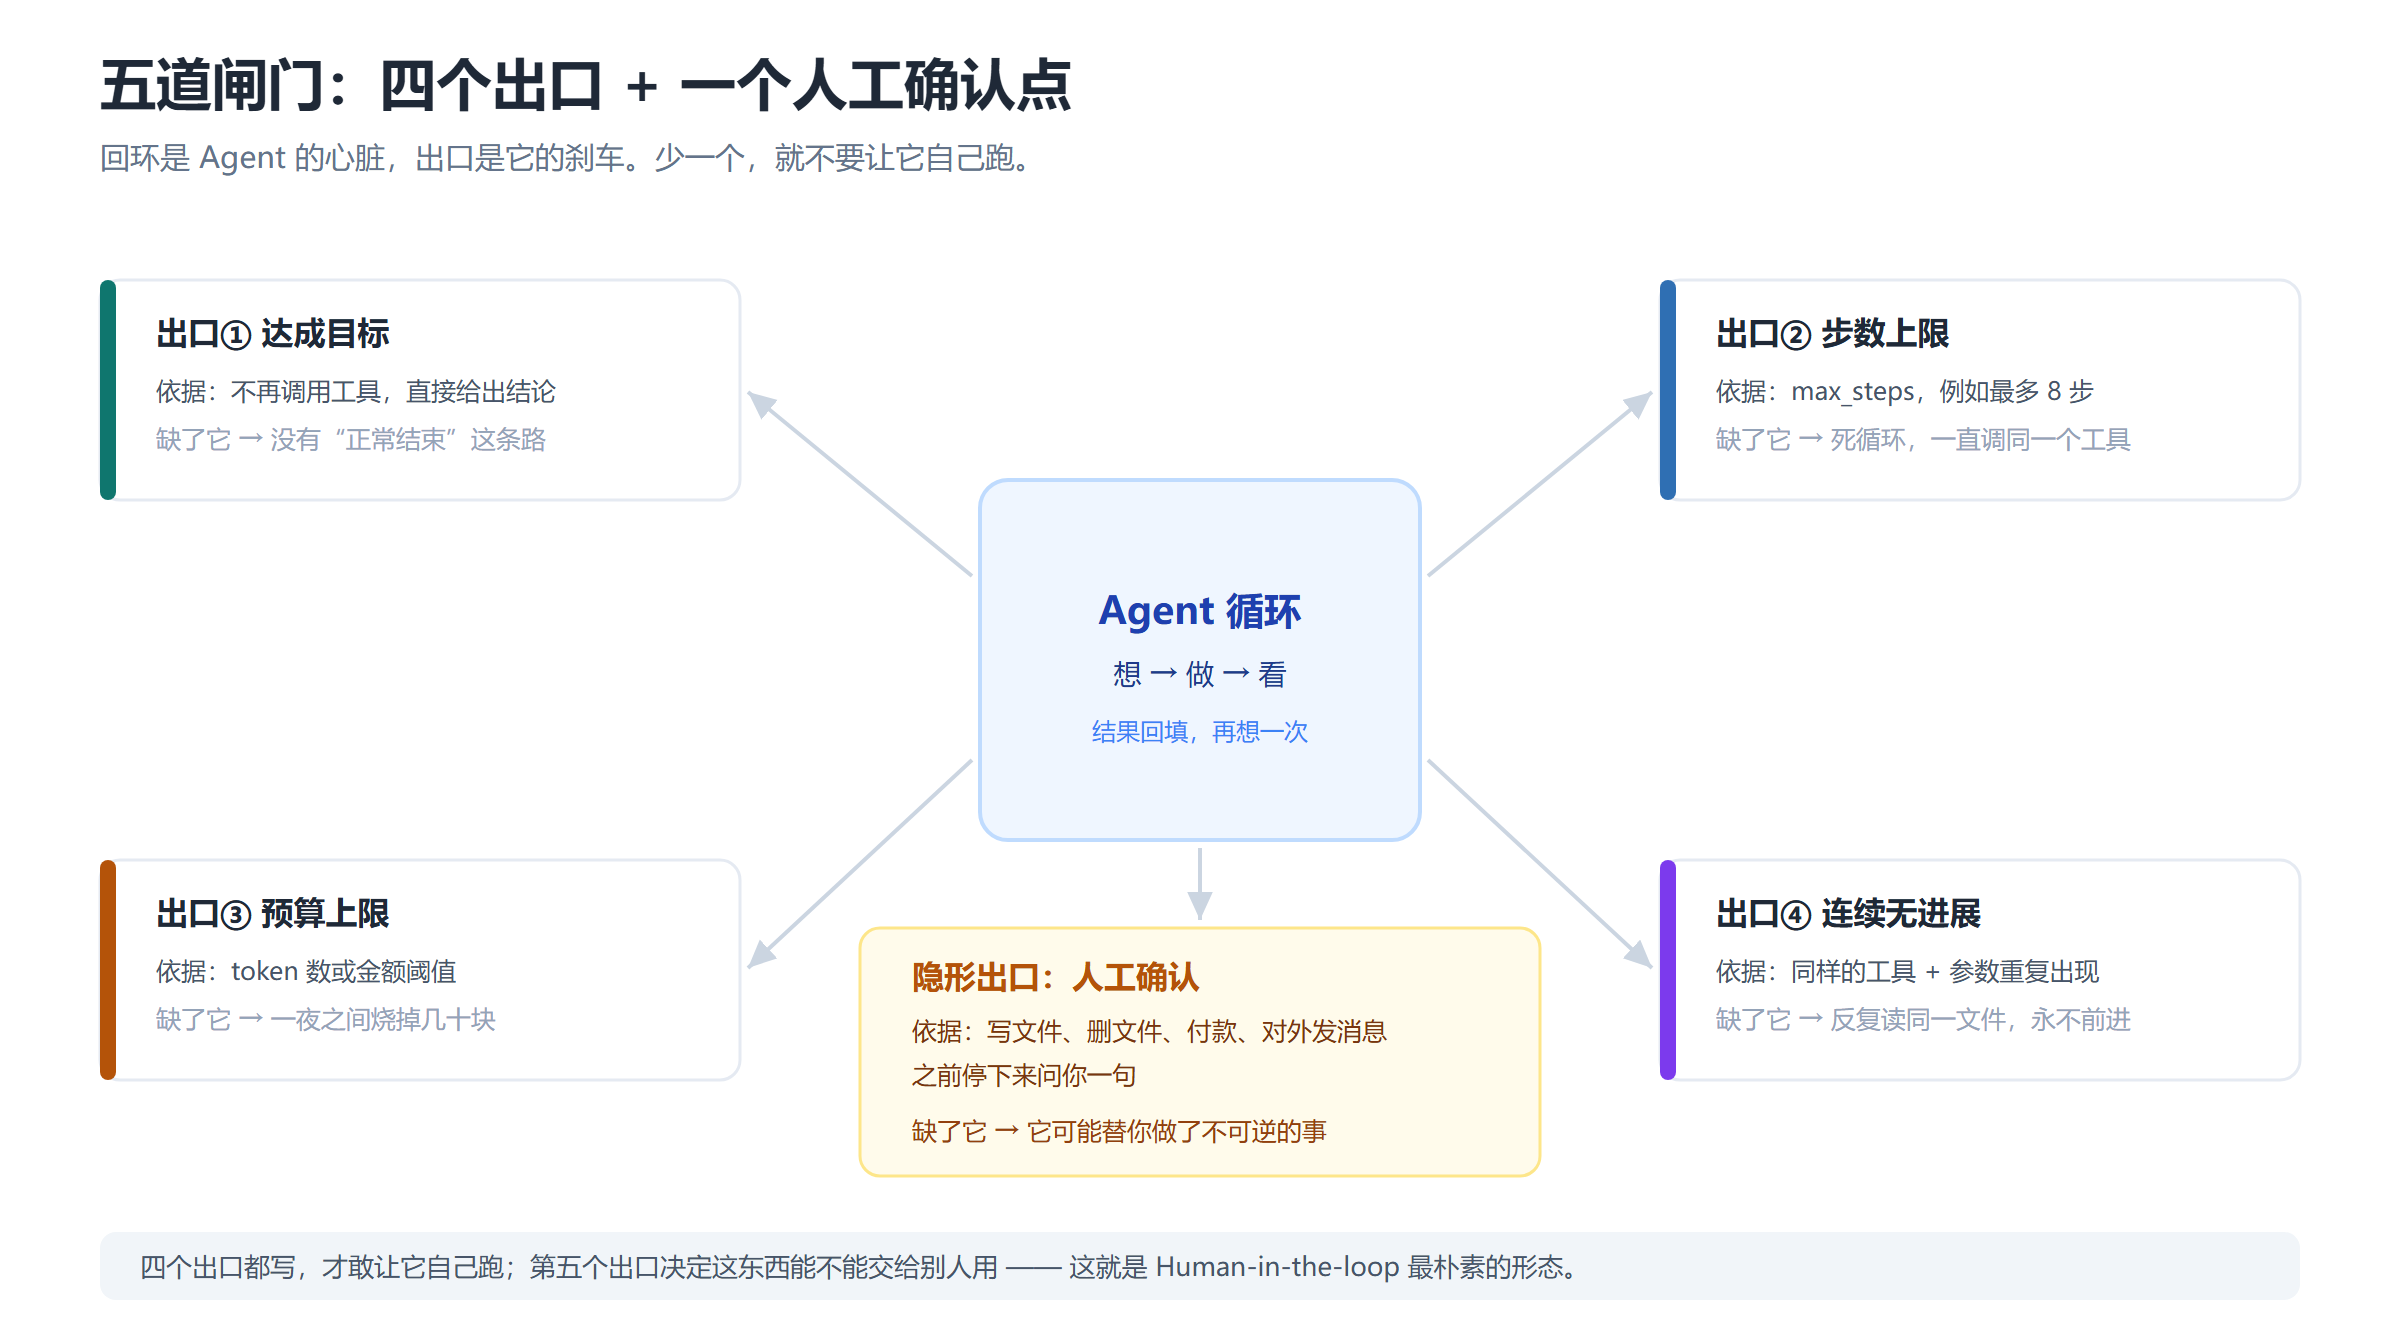
| 出口 | 判断依据 | 没有它会怎样 |
|---|---|---|
| ① 达成目标 | 模型说"做完了" | —— |
| ② 超过步数上限 | 例如最多 8 步 | 陷入死循环,一直调同一个工具 |
| ③ 超过预算 | token 或金额上限 | 一夜之间烧掉几十块 |
| ④ 连续无进展 | 同样的动作重复出现 | 反复读同一个文件,永远不前进 |
还有第五个隐形出口:遇到危险动作(写文件、删文件、付款、对外发消息)时停下来问人。这个出口在下面代码里是开着的。
5.2 最小 Agent 的三件套
一个能干活的最小 Agent,只需要三样东西:
| 组成 | 是什么 | 在我们的代码里 |
|---|---|---|
| 模型 | 会思考、会决定调用什么 | call_model() |
| 工具 | 能真的动手机器的东西 | TOOLS 定义 + run_tool() |
| 循环 | 把"想 → 做 → 看"串起来,并有出口 | for step in range(max_steps) |
去掉任何一个,它就不是 Agent:去掉工具 → 变成聊天;去掉循环 → 变成一次函数调用;去掉模型 → 变成固定脚本。
5.3 先说安全:为什么只给三个受限工具
在写代码之前,先定一条规矩:给 Agent 的每一个能力,都要假设它会被用错。
下面是我在真实环境里做的越界测试(代码在 safe_path()):
| 模型可能给出的路径 | 结果 |
|---|---|
../../Windows/System32/x.txt |
拒绝:路径越界 |
C:/Windows/x.txt |
拒绝:路径越界 |
inbox/../output/ok.md |
允许(解析后确实在 lab 内) |
../../evil.md(写操作) |
拒绝:写操作基准是 output/,越界即拒 |
这段逻辑只有三行,但它是整个脚本最重要的一段:
def safe_path(rel: str, base: Path) -> Path:
    p = (base / rel).resolve()
    if not p.is_relative_to(base):
        raise PermissionError(f"路径越界,已拒绝:{rel}")
    return p
为什么不用"检测有没有 .."这种办法:因为路径可以绕过(符号链接、绝对路径、编码变形)。先解析成真实绝对路径,再判断它是否在允许范围内,才是可靠的。
所以本卷给的三个工具是刻意选的:
| 工具 | 能力 | 限制 | 为什么这么设计 |
|---|---|---|---|
list_files |
列目录 | 只读,最多 80 项 | 让它"先看再动手",而不是猜 |
read_text |
读文件 | 只读,最多 4000 字符 | 防止一次把整个上下文塞满 |
write_report |
写文件 | 只能写 output/,且必须人工确认 |
唯一的写权限,风险最高的一个 |
没有给它的能力:删文件、执行 shell 命令、访问网络、发邮件。这些不是"以后再说",而是"等你理解了它们的风险再给"。卷 2 讲权限与安全时会展开。
5.4 完整实现
完整可运行文件:code/first_agent.py(约 200 行,其中真正的 Agent 逻辑不到 60 行,其余全是边界和错误处理——这个比例是刻意的)。
第一步:工具定义(告诉模型"你能做什么")
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "list_files",
            "description": "列出 lab 目录下某个子目录里的文件,返回文件名、大小。只读。",
            "parameters": {
                "type": "object",
                "properties": {
                    "path": {"type": "string", "description": "相对 lab 的目录路径,例如 inbox"},
                },
                "required": ["path"],
            },
        },
    },
    # read_text、write_report 结构相同,略
]
三个设计要点,卷 2 会展开,这里先记住:
description是写给模型看的,写得越清楚,它选错工具的概率越低;- 参数用 JSON Schema 约束,
required里的字段它必须给; - 工具名要动词开头、语义单一(
read_text而不是file_ops)。
第二步:执行工具(真的动手)
def run_tool(name: str, args: dict, auto_yes: bool) -> str:
    try:
        if name == "list_files":
            return tool_list_files(args)
        if name == "read_text":
            return tool_read_text(args)
        if name == "write_report":
            return tool_write_report(args, auto_yes)
        return f"错误:没有名为 {name} 的工具。"
    except PermissionError as e:
        return f"已拒绝:{e}"
    except Exception as e:
        return f"工具执行异常:{type(e).__name__}: {e}"
注意最后两个 except:工具出错时,不要把异常抛出去让程序崩掉,而是把错误信息作为"工具结果"返回给模型。
这是 Agent 和普通程序最大的差别之一:模型能读懂错误信息并自我修正。 你告诉它"文件不存在,先用 list_files 看看",它下一步就真的会去看。
第三步:主循环(心脏)
messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": task},
]

for step in range(1, max_steps + 1):                 # 出口②:步数上限
    resp = model(messages, TOOLS, cfg)               # 1. 让模型想
    msg = resp["choices"][0]["message"]
    calls = msg.get("tool_calls") or []
    content = (msg.get("content") or "").strip()

    # 出口①:模型不再调用工具,给出结论
    if content and not calls:
        print(content)
        break
    if not calls:                                    # 既没内容也没调用 → 别空转
        break

    # 把模型这一步的决定记进对话
    messages.append({"role": "assistant", "content": msg.get("content"),
                     "tool_calls": calls})

    repeat_hit = False
    for c in calls:                                  # 2. 执行它要的每一个工具
        name = c["function"]["name"]
        targs = json.loads(c["function"]["arguments"] or "{}")

        sig = name + json.dumps(targs, sort_keys=True)
        if sig in seen_calls:                        # 出口④:同样动作重复 → 收手
            repeat_hit = True
            result = "你已经用同样的参数调用过这个工具,不要重复。请换思路或结束任务。"
        else:
            seen_calls.add(sig)
            result = run_tool(name, targs, args.yes)

        # 3. 把结果塞回对话 —— 这一行就是“回环”
        messages.append({"role": "tool", "tool_call_id": c.get("id", ""),
                         "content": result})

    if repeat_hit:
        break
    if used_tokens > budget:                         # 出口③:超预算
        break
就这些。 去掉打印、参数解析、错误处理,核心不到 20 行。
5.5 逐段拆解:四个必须理解的点
① messages 数组是整个 Agent 的状态
它里面有四种角色:
| role | 谁 | 作用 |
|---|---|---|
system |
你(开发者) | 定规矩:能做什么、不能做什么、怎么输出 |
user |
用户 | 提需求 |
assistant |
模型 | 它的回答,或者它要调用的工具 |
tool |
你的程序 | 工具的执行结果,必须带 tool_call_id 对应是哪次调用 |
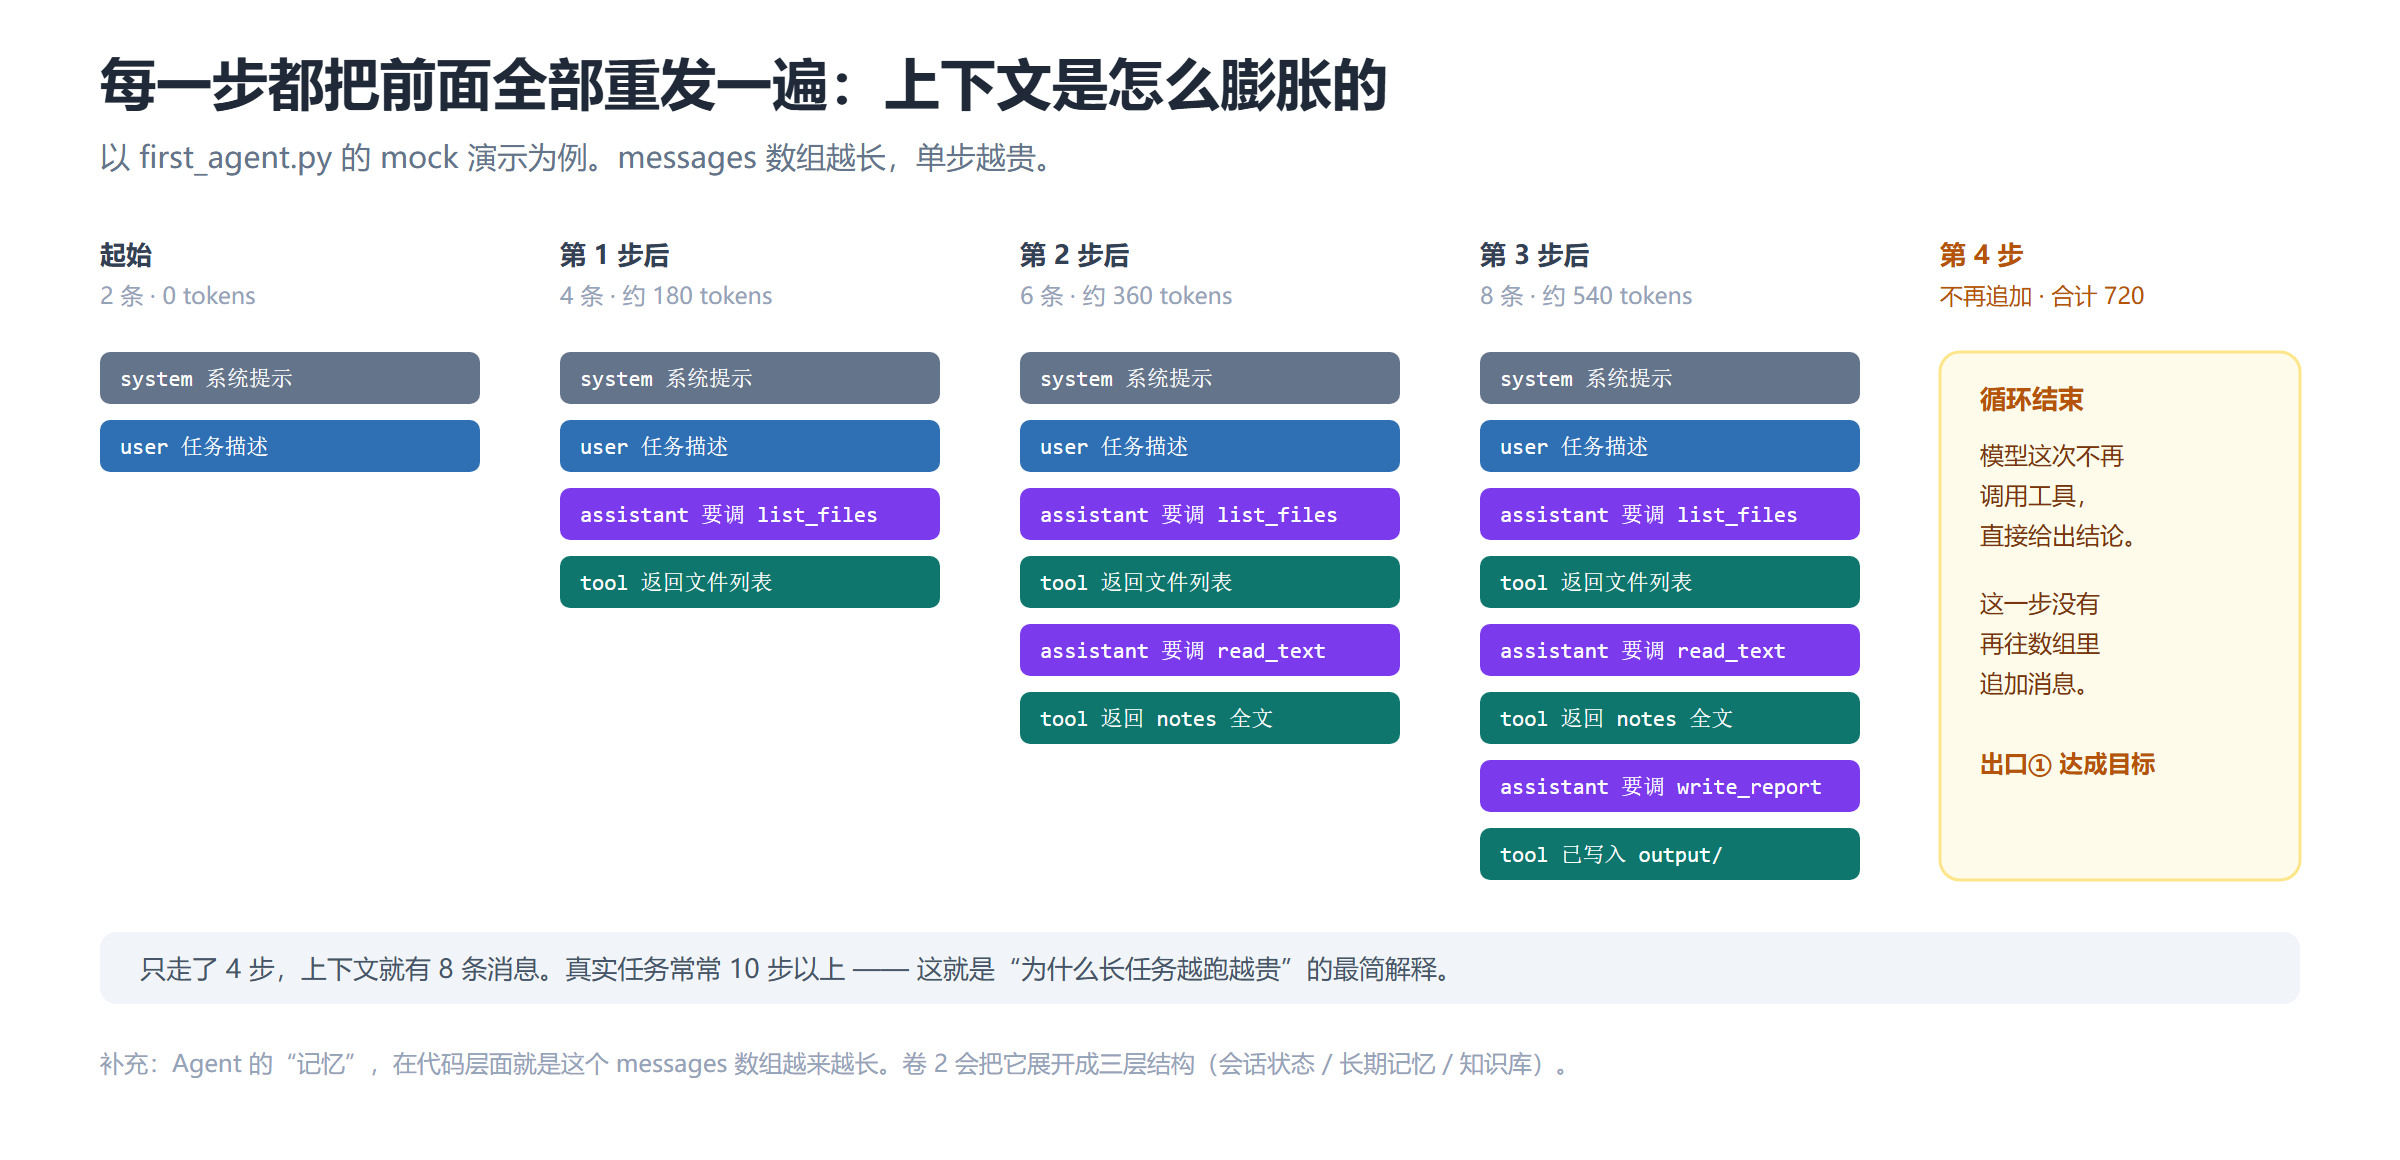
每转一圈,这个数组都会变长——这就是成本来源。第 8 步的时候,前 7 步的全部内容(包括工具返回的完整文件内容)都会被重新发一遍。
② tool_calls 是"意图",不是"执行"
模型返回的 tool_calls 只是一份申请:它说"我想调 read_text,参数是 {"path":"inbox/notes.md"}"。真正执行的是你的代码。 这个区别极其重要:
模型永远不能直接操作你的电脑。它能做的只有"请求",批准和执行权在你手里。
理解了这一点,你就明白了为什么"Agent 删了我的文件"这类新闻,本质是程序给了它不该给的权限,而不是模型有了自主意识。
③ 工具结果必须回填,否则它不知道发生了什么
messages.append({"role": "tool", ...}) 这一行是整个循环的关键。漏了它,模型会一直重复同一个调用——因为它以为工具还没执行。
④ 四个出口都要写,少一个都是隐患
对照 5.1 的表格:达成目标(第 1 个 break)、步数上限(for 的上界)、预算(if used_tokens > budget)、无进展(seen_calls + repeat_hit)。四个都写了,才敢让它自己跑。
为什么"无进展"要先拦一次再退出:代码里把重复动作的提示作为工具结果回给模型,让它有机会换思路;同一轮里发现重复才退出。这样既不冤枉它,也不会真的绕进去。
5.6 跑起来:三个任务,从演示到真跑
先跑不需要密钥的演示
cd ai-agent-lab/code
python first_agent.py "把 inbox 里的文件整理成一份清单,写到 output/inventory.md" --setup --mock --yes
--setup 会建好目录和两个演示文件,--mock 用一个假模型按剧本走完整个循环。实际输出:
已准备好演示数据:C:\Users\你\ai-agent-lab
  inbox
  inbox\data.csv
  inbox\notes.md
  output

==============================================================
任务:把 inbox 里的文件整理成一份清单,写到 output/inventory.md
工作目录:C:\Users\你\ai-agent-lab
模式:mock(假模型)
上限:8 步 · 20000 tokens
==============================================================

--- 第 1 步 ---
[工具] list_files {"path": "inbox"}
[结果] [文件] data.csv  29 字节
[文件] notes.md  95 字节

--- 第 2 步 ---
[工具] read_text {"path": "inbox/notes.md"}
[结果] # 会议记录
- 下周一交初稿
- 图表要改成 300dpi
- 参考文献补到 40 篇

--- 第 3 步 ---
[工具] write_report {"filename": "inventory.md", "content": "..."}

!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
Agent 想写文件:C:\Users\你\ai-agent-lab\output\inventory.md
内容长度:68 字符,前 200 字预览:
--------------------------------------------------------------
# 清单
- 由 first_agent.py 的 mock 模式生成
--------------------------------------------------------------
[结果] 已写入 ...\output\inventory.md(68 字符)。

--- 第 4 步 ---
[模型] mock 剧本已走完。上面每一步的工具调用与结果都是真实的,
       只有这段总结是我写死的;真跑的时候,这段由模型自己生成。

==============================================================
结束原因:模型判断任务已完成
累计消耗:720 tokens · 共 8 条消息在上下文里
这段输出你要看懂三件事:
- 每一步都有一个
[工具]和一个[结果]—— 这就是"动手 → 看结果"; - 第 3 步被拦下来问你确认 —— 这就是人工闸门;
- 最后一行"共 8 条消息在上下文里" —— 才 4 步,上下文已经有 8 条消息。这就是成本增长的方式。
再看它会拒绝
python first_agent.py "整理清单" --mock
# 不带 --yes 时,写文件前会要求确认;非交互环境下会直接拒绝
真跑
python first_agent.py "把 inbox 里的文件整理成一份清单,写到 output/inventory.md"
换三个你自己的任务
| 任务 | 它在验证什么 |
|---|---|
把 inbox 里的文件按类型分类,写一份说明 |
多工具协作 |
读 inbox/notes.md,把里面的待办事项提取成清单 |
读 + 结构化输出 |
看看 output 里有什么,如果没有报告就生成一份 |
条件判断 + 写权限 |
5.7 它一定会失败:四种典型崩法
这一节比前面所有代码都重要。 第一次跑真实模型,大概率不会一次成功。下面是必然遇到的四种情况:
| 崩法 | 现象 | 根本原因 | 怎么改 |
|---|---|---|---|
| 不调工具,直接编 | 它说"我已经帮你整理好了",但 output/ 里什么都没有 |
模型觉得"我能推理出来";或系统提示没强调"必须先看" | 系统提示加硬规则:"需要了解文件时先调用工具,不要凭猜测回答" |
| 参数给错 | read_text 收到 {"file": "notes.md"},缺 path |
工具描述的字段名不清晰 | 参数名用最直白的词;description 写清"相对 lab 的路径,例如 inbox/notes.md" |
| 重复调用 | 反复读同一个文件,5 步都卡在这 | 它没意识到"上次结果已经在上下文里" | 我们加了 seen_calls 拦截;同时给它提示:"同样的参数不要重复" |
| 过早收手 | 只读了目录就说"完成了" | 它把"了解情况"当成了"完成任务" | 系统提示里写清完成标准:"任务完成的标准是 output/ 里出现了文件" |
这四种崩法对应四种能力:约束(提示词)、描述(工具设计)、状态(循环)、验收(完成标准)。你未来 80% 的调试时间,都会花在这四件事上。
想自己复现一遍?把任务改成"读完 notes.md 直接写报告,不要列目录",然后观察它第一步做了什么——这就是第 3 种和第 4 种崩法的合体。
5.8 加一个人工确认点
代码里最关键的一段不是循环,是这个函数:
def tool_write_report(args: dict, auto_yes: bool) -> str:
    target = safe_path(args.get("filename", "report.md"), OUTPUT)   # 只能写 output/
    content = args.get("content", "")
    print(f"Agent 想写文件:{target}")
    print(content[:200])

    if not auto_yes:
        if not sys.stdin.isatty():          # 非交互环境(如定时任务)不能默默通过
            return "已拒绝:写文件需要人工确认。确认无误请加 --yes 重跑。"
        if input("确认写入?[y/N] ").strip().lower() not in ("y", "yes"):
            return "用户拒绝了这次写入。请换一种方式。"

    target.write_text(content, encoding="utf-8")
    return f"已写入 {target}"
三个设计意图:
- 确认发生在"写入前",而不是"写入后"——事后通知没有意义;
- 拒绝也要作为工具结果返回给模型,让它知道"被拒了,别硬来";
- 非交互环境默认拒绝——定时任务里没人看着,宁可不做,不能乱做。
这就是"Human-in-the-loop"最朴素的形态。卷 2 会讲它的完整版(审批流、中断恢复、超时兜底),但核心就是这三行判断。
5.9 本章验收
- 应当会跑通
--mock演示,并解释每一步发生了什么; - 应当会修改任务描述,让它完成一件你自己的小事(真实文件,不是演示数据);
- 应当会说出四个终止条件分别在哪一行代码里;
- 应当会说明为什么
write_report必须人工确认,而list_files不需要; - 应当会制造一次失败(把任务改成"读完 notes.md 直接写报告,不要列目录"),观察它怎么应对。
自测题:
| 题 | 关键点 |
|---|---|
删掉 messages.append({"role": "tool", ...}) 会怎样? |
模型以为工具没执行,反复重复同一调用 |
| 只写步数上限、不写预算上限,风险是什么? | 步数虽封顶,但单步上下文可能已经很大;长任务仍可能超支 |
--yes 在什么场景下绝对不能加? |
无人值守的定时任务,或写操作指向不熟悉的目录时 |
为什么工具错误要 return 而不是 raise? |
错误信息要成为工具结果回填,模型才能自我修正 |
5.10 下一步
Agent 有了,去验收和选路径 → 第 6 章 收口:自检、分叉与下一卷
回看:第 4 章 三条链路打通 · 返回导读